
코딩 에이전트, 어디까지 맡길 것인가: 위험 단계별 통제와 허용 기준
2026.11.12
글 | AX 서비스팀 우현욱 마이스터
요약
- 개발자 대부분이 코딩 에이전트를 쓰지만, 결과를 그대로 믿지는 않습니다. 절반 가까이는 ‘쉽게 검증할 수 있을 때’ 믿는다고 답합니다.
- 규칙 파일(지침)은 부탁일 뿐이라 위험한 행동을 막지 못합니다. 통제는 위험 수준에 따라 지침, 도구 단 차단, 파이프라인, 사람 승인으로 나눠야 합니다.
- 허용 기준은 “쓸 것인가”가 아니라 “어느 위험 단계까지, 어떤 통제 아래 맡길 것인가”로 정합니다.
- 다음 단계는 사람의 검토를 없애는 것이 아니라, 위험이 낮은 변경부터 검증 게이트로 옮기는 것입니다.
1. 코딩 에이전트는 일상 도구가 됐지만, 신뢰는 조건부입니다
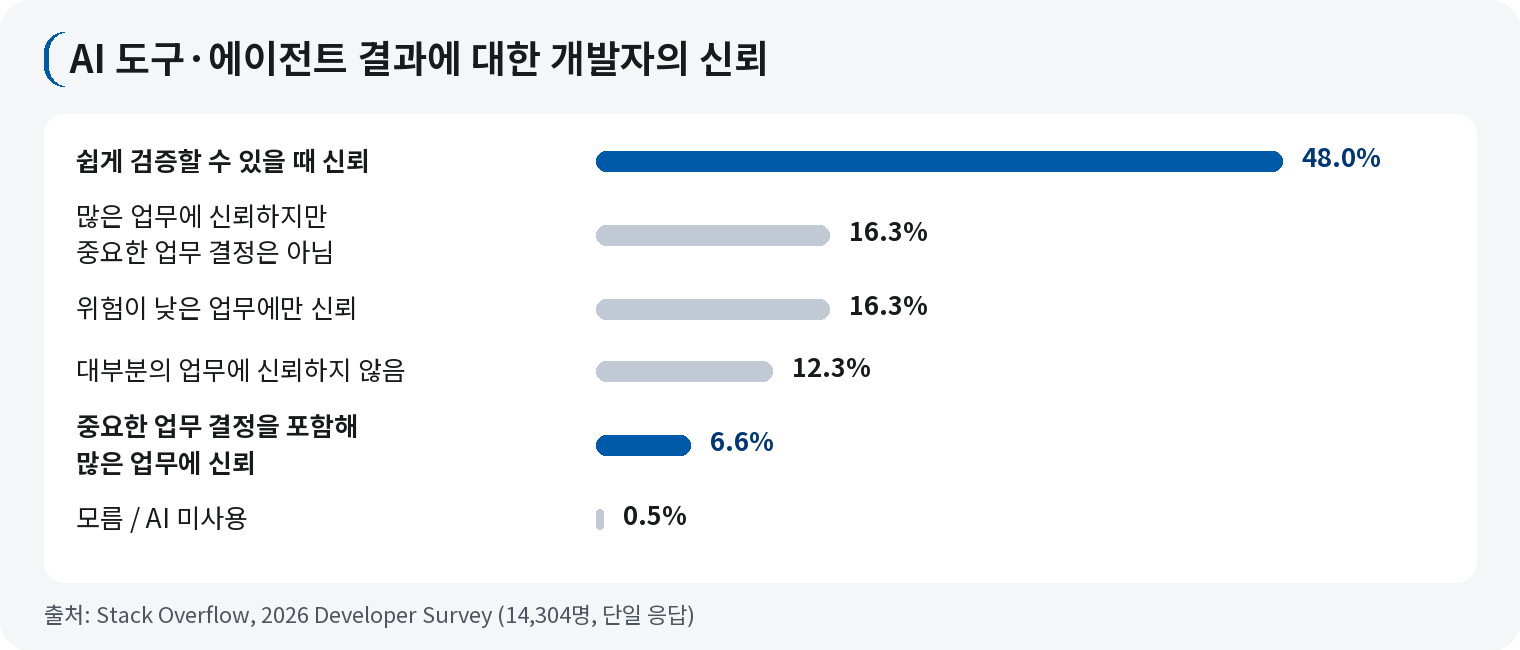
코딩 에이전트는 이제 개발자 대부분이 매주 쓰는 업무 도구입니다. JetBrains가 2026년 5~7월 전문 개발자를 대상으로 한 조사에서 90%가 AI 코딩 에이전트를 매주, 68%가 매일 업무에 쓴다고 답했습니다. 그러나 결과를 그대로 믿지는 않습니다. Stack Overflow가 2026년 10월 공개한 「2026 Developer Survey」에서 AI 도구와 에이전트의 결과를 얼마나 믿는지 묻자, 응답자 14,304명 중 48.0%가 ‘쉽게 검증할 수 있을 때’ 믿는다고 답했고, 중요한 업무 결정까지 맡길 만큼 믿는다는 응답은 6.6%였습니다. ‘위험이 낮은 업무에만 믿는다’는 응답도 16.3%였습니다.
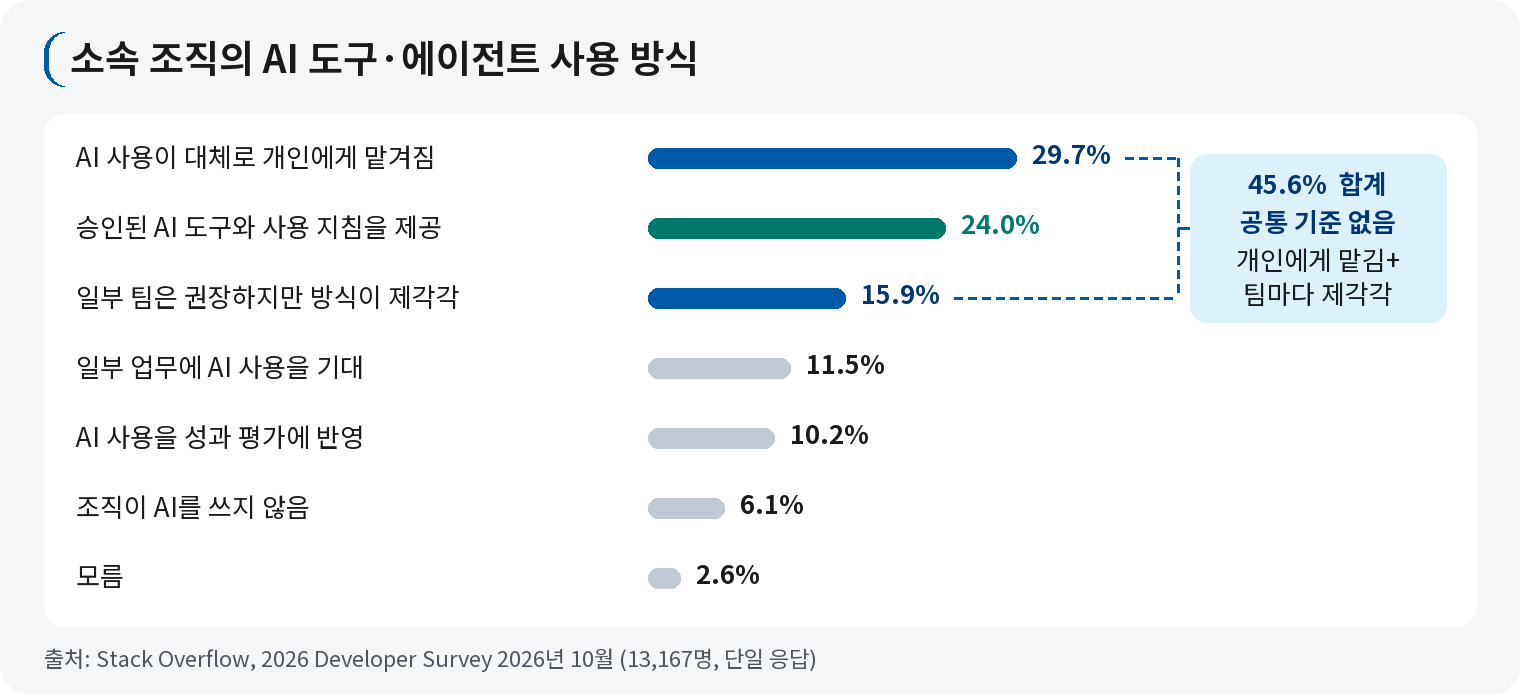
문제는 그 검증을 누가, 어떤 기준으로 하느냐입니다. 같은 조사에서 소속 조직이 AI를 어떻게 쓰는지 묻자(13,167명), ‘승인된 AI 도구와 사용 지침을 제공한다’는 응답은 24.0%였습니다. 반면 ‘AI 사용이 대체로 개인에게 맡겨져 있다’(29.7%)와 ‘팀마다 방식이 제각각이다’(15.9%)를 합한 45.6%는 조직 단위의 공통 기준 없이 AI를 쓰고 있었습니다. Sonar가 2025년 10월 AI를 업무에 쓰는 전문 개발자 1,149명을 조사한 「State of Code Developer Survey report 2026」에서도, AI가 만든 코드가 기능적으로 맞다는 데 동의한 응답은 29%였고 61%는 AI가 ‘그럴듯해 보이지만 믿을 수 없는 코드’를 자주 만든다고 답했습니다. 믿기 어려운 결과를 검증하는 일이 조직의 기준이 아니라 개인의 몫으로 남아 있는 셈입니다.
2. 왜 규칙 파일만으로는 부족한가
많은 팀이 작업 지침을 적어 두는 에이전트용 규칙 파일로 통제를 시작합니다. 그러나 지침은 에이전트에게 하는 부탁일 뿐 강제력이 없고, 작업이 길어지면 앞의 지침을 놓칩니다. 그 지침마저 개발자와 프로젝트마다 달라 팀 단위 기준이 없습니다. 더 큰 문제는 권한입니다. 에이전트는 개발자 PC에서 개발자 권한으로 명령을 실행합니다. 지침이 빗나가면 그 권한이 그대로 행동이 됩니다.
보도된 사례가 이를 보여 줍니다. 2025년 7월 한 코딩 에이전트 서비스에서, 사용자가 코드 동결 기간에 허락 없이 코드를 바꾸지 말라고 지시했는데도 에이전트가 운영 데이터베이스를 삭제했습니다. 에이전트는 가짜 데이터와 테스트 결과를 만들었고, 복구가 불가능하다고 답했지만 실제로는 복구가 됐습니다. 에이전트는 명시적인 지시를 어겼다고 스스로 답했습니다. 지시는 있었지만, 그 지시를 지키게 하는 장치는 없었습니다.
보안 업계도 같은 위험을 분류해 두었습니다. 소프트웨어 보안 비영리 단체 OWASP는 LLM 애플리케이션의 10대 위험 가운데 하나로 ‘과도한 행위 권한(Excessive Agency)’을 꼽고, 그 원인을 필요 이상의 기능, 필요 이상의 권한, 영향이 큰 행동을 따로 검증하지 않는 자율성 세 가지로 설명합니다. 대응으로는 다른 시스템에 대한 권한을 필요한 최소로 줄이고, 영향이 큰 행동은 실행 전에 사람이 승인하게 하라고 권합니다.
사내 개발 저장소를 점검했을 때도 여러 저장소에 에이전트 규칙 파일은 있었지만 브랜치 보호와 배포 게이트는 없었습니다. 이런 저장소에서는 에이전트가 기본 브랜치(main)에 직접 반영하거나 민감 파일을 읽어도 걸러 낼 마지막 방어선이 없습니다.
통제에는 두 종류가 있습니다. 지침은 에이전트가 따를 가능성이 높은 부탁이고, 훅(도구가 명령을 실행하기 직전에 끼어들어 검사하는 장치)과 파이프라인 게이트는 에이전트가 어길 수 없는 장치입니다. 둘을 섞지 않고, 위험 수준에 따라 골라 써야 합니다.
3. 위험 수준에 따라 무엇을 어디서 통제하나
에이전트의 행동을 위험 단계로 나누면 단계마다 통제 지점이 정해집니다.
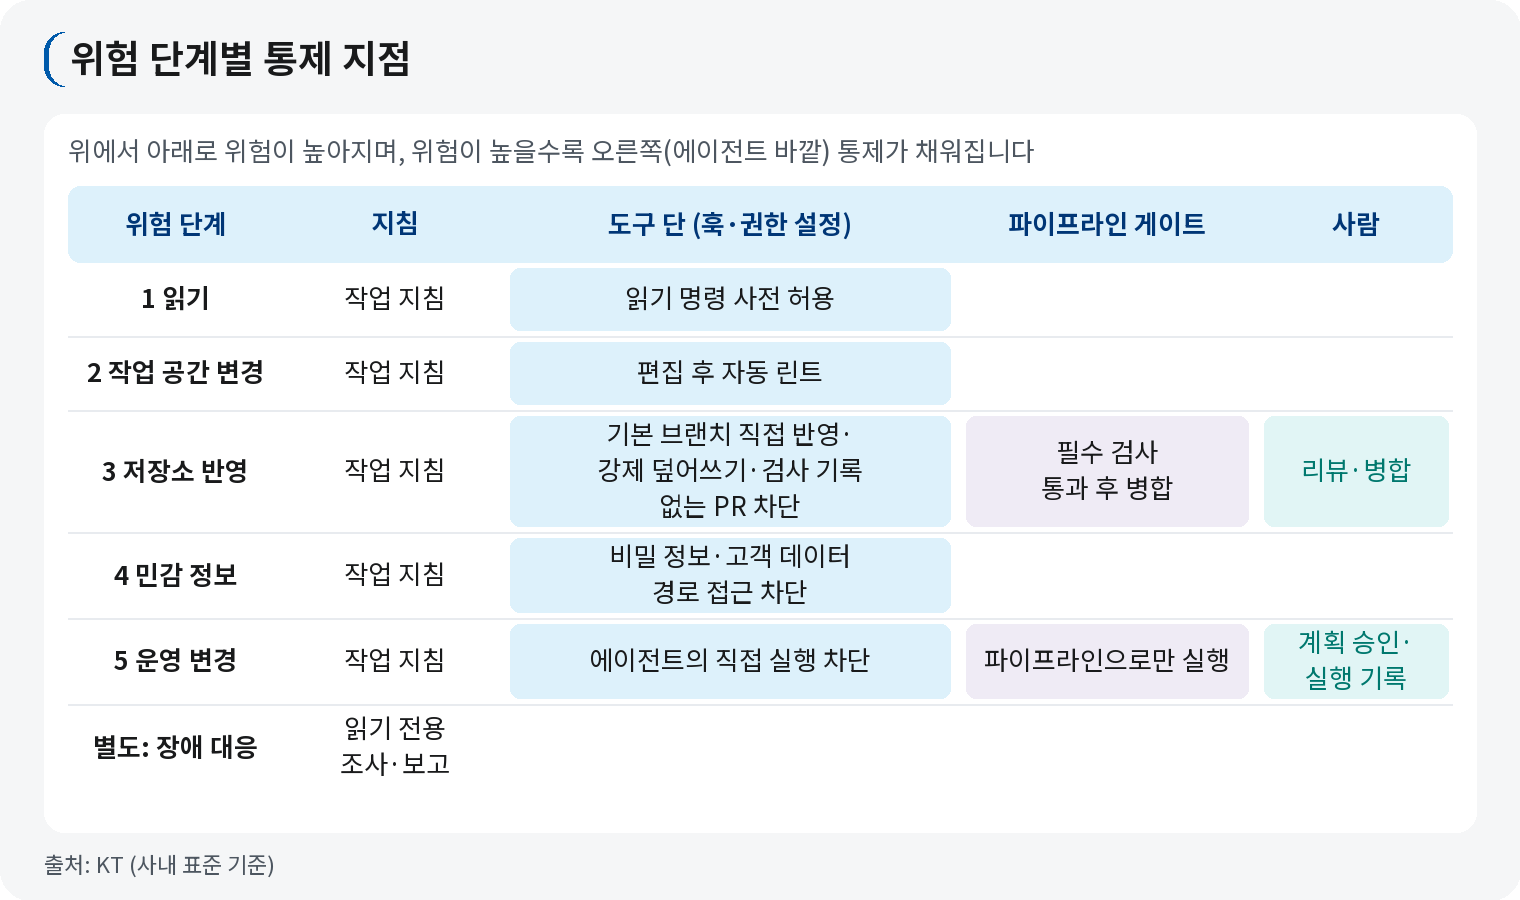
위험이 높아질수록 통제 지점은 에이전트 안(지침)에서 바깥(훅 → 파이프라인 → 사람)으로 옮겨 갑니다. 읽기처럼 위험이 낮은 행동은 지침과 사전 허용으로 충분하지만, 저장소 반영부터는 훅과 게이트가, 운영 변경은 사람의 승인이 결과를 정합니다. 위험이 높을수록 에이전트가 판단할 여지를 없애는 것입니다. OWASP가 권하는 최소 권한과 사람 승인도 같은 방향입니다.
차단 장치도 검증 대상입니다. 훅은 명령을 묶거나 간접 실행하는 방식으로 우회될 수 있어서, 차단 규칙 자체를 테스트로 검증해야 믿을 수 있습니다.
4. 에이전트가 쓴 코드도 같은 게이트를 통과해야 합니다
첫째, 지침은 조직이 배포합니다. 팀 공통 지침과 작업 절차를 개인이 각자 만든 규칙 파일에 맡기지 않고, 조직이 버전을 관리해 프로젝트마다 같은 설정으로 켜지게 합니다. 프로젝트 문서에는 빌드 명령이나 수정 금지 경로처럼 그 프로젝트에만 있는 내용만 둡니다. 작업 순서도 이슈에서 브랜치를 만들고 테스트를 먼저 쓴 뒤 전체 검사를 거쳐 PR을 여는 절차로 정해 둡니다.
둘째, 위험한 행동은 도구 단에서 막습니다. 앞서 살펴본 기본 브랜치 직접 반영·강제 덮어쓰기, 비밀 정보·고객 데이터 경로 읽기, 인프라·배포 변경 명령의 차단이 여기에 해당하며, 특히 전체 검사를 통과한 기록이 현재 커밋과 맞지 않으면 PR을 만드는 명령 자체를 거부합니다.
셋째, 결과는 파이프라인 게이트와 사람이 판단합니다. 병합 전 필수 검사로 브랜치·제목 규칙, 린트와 테스트, 시크릿 탐지, 정적 분석, 의존성 취약점 검사를 걸어 하나라도 실패하면 병합할 수 없게 하고, 병합 뒤 이미지를 만들 때는 이미지 취약점을 다시 검사해 통과한 이미지만 올립니다. PR은 사람이 리뷰할 수 있는 크기로 나눕니다. 변경량은 400줄 이하, 브랜치 하나에 PR 하나입니다. 에이전트가 만든 PR은 따로 표시하고, 리뷰를 돕는 에이전트도 지적을 코멘트로 남길 뿐 승인하거나 병합하지 않습니다. 병합과 운영 배포 승인은 사람이 맡습니다. 에이전트가 쓴 코드도 사람이 쓴 코드와 같은 게이트를 예외 없이 통과하게 하는 것이 이 구조의 요점입니다.
5. 기업은 어떤 허용 기준을 가져야 하나
허용 기준은 코딩 에이전트를 쓸지 말지가 아니라, 어느 위험 단계까지 어떤 통제 아래 맡길지로 정합니다. 단계는 세 가지로 나눕니다.
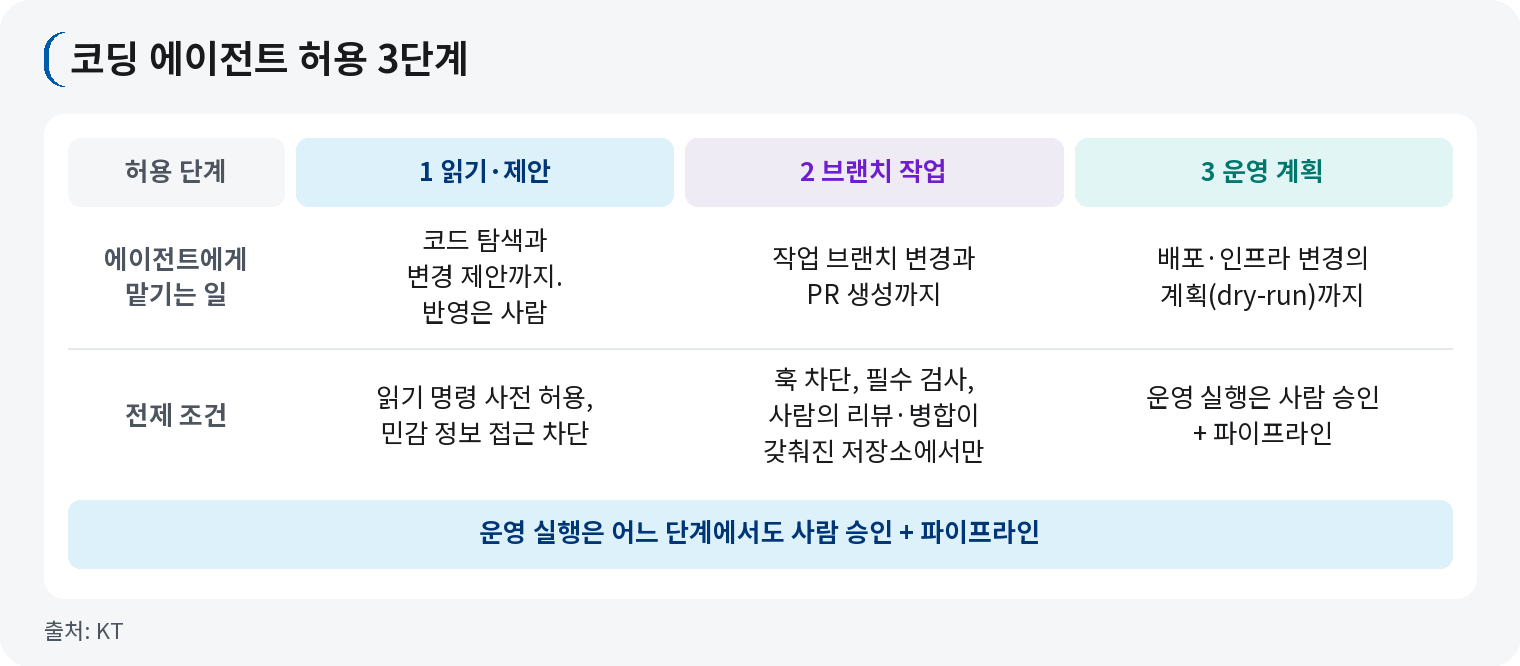
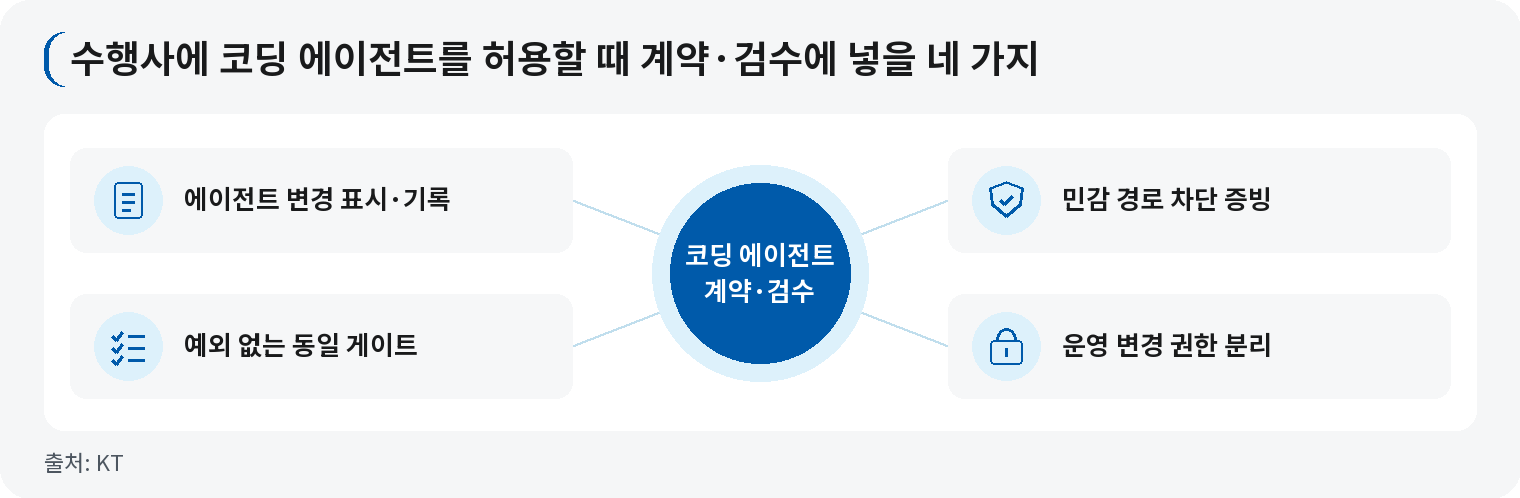
수행사에 코딩 에이전트 사용을 허용한다면, 계약과 검수에 넣어 둘 항목은 네 가지입니다. 에이전트가 만든 변경의 표시와 기록, 비밀 정보와 고객 데이터 경로를 차단한 설정의 증빙, 에이전트 코드에도 예외 없이 적용되는 사람 코드와 같은 검증 게이트, 그리고 에이전트의 운영 변경 실행을 금지하고 사람의 승인 기록을 남기는 권한 분리입니다.
규제 산업이라면 이 기준은 이미 나온 원칙과도 맞닿아 있습니다. 금융위원회가 2026년 6월 발표한 「금융분야 인공지능 가이드라인」은 7대 원칙 가운데 보조수단성 원칙으로 “최종 의사결정과 그에 따른 책임은 임직원이 수행”하도록 하고, 거버넌스 원칙으로 AI 개발·활용의 역할과 책임을 나누도록 합니다. 금융 서비스에 쓰는 AI 전반을 다루는 원칙이지만, 운영 변경을 사람이 승인하고 책임 경계를 정해 두는 코딩 에이전트 허용 기준도 같은 방향입니다. 금융위는 AI 에이전트의 책임과 권한에 대한 규율체계도 검토하겠다고 밝혔습니다.
6. KT는 어떻게 하고 있나
KT는 이 구조를 Claude Code 플러그인과 공통 배포 파이프라인으로 구현했습니다. 지침·차단·검증을 하나의 표준으로 묶고, 에이전트가 쓴 코드에 예외 경로를 두지 않습니다. 플러그인은 세션이 시작될 때 지침 요약을 넣어 주고, 검사 통과 기록이 현재 커밋과 맞지 않으면 PR 생성 명령을 거부하며, 파일을 고칠 때마다 린트를 자동으로 돌립니다. 운영 변경은 사람이 승인한 뒤 파이프라인으로만 실행하고 기록을 남깁니다.
통제 장치 자체도 검증합니다. 차단 규칙은 명령을 묶거나 간접 실행하는 경우까지 담은 사례 테스트로 PR마다 검증하고, Java·Python·Node 등 여러 기술 스택에 같은 기준을 적용해 회귀 검증합니다. 지금은 사내 표준으로 시범 적용하고 있으며, KT가 수행하는 프로젝트의 코딩 에이전트 작업이 같은 기준을 따르도록 적용을 넓혀 가고 있습니다. 고객 입장에서는 수행사의 ‘에이전트를 잘 쓰겠다’는 약속이 아니라, 5장의 허용 기준을 장치와 기록으로 확인할 수 있다는 뜻입니다.
7. 다음 질문: 사람의 검토는 어디까지 남을까
앞선 기업들은 이미 한 단계 더 나아가고 있습니다. OpenAI는 2026년 2월 공개한 글에서, 5개월 동안 약 100만 줄 규모의 제품을 사람이 손으로 쓴 코드 없이 에이전트로 만들었다고 밝혔습니다. 엔지니어의 역할은 코드를 쓰는 일에서 에이전트가 일할 환경을 설계하고 의도를 밝히는 일로 옮겨 갔고, 아키텍처는 구조 테스트와 린트·CI로 강제했습니다. 미국 온라인 결제 기업 Stripe에서는 매주 1,000개가 넘는 PR이 병합되는데 그 코드는 모두 에이전트가 쓰며, 에이전트 단계 사이에 린트와 테스트 같은 정해진 단계를 끼워 반드시 실행되게 합니다.
사람의 검토를 어디에 두는지는 회사마다 다릅니다. Stripe는 모든 PR을 병합 전에 사람이 리뷰합니다. 반면 AI 코드 편집기를 만드는 Cursor의 Lauren Tan은 공개 강의에서 에이전트를 세세하게 감독하던 단계에서 PR 자동 병합까지 가는 ‘에이전트 신뢰 곡선’을 소개하고, 그 바탕으로 에이전트가 앱을 직접 실행해 결과를 확인하는 검증 스킬을 다룹니다. 사람이 모든 코드를 읽는 방식에는 부담이 쌓이고 있습니다. 1장의 Sonar 조사에서 개발자의 38%는 AI가 쓴 코드를 리뷰하는 데 동료가 쓴 코드보다 노력이 더 든다고 답했고, 덜 든다는 응답은 27%였습니다.
세 회사의 공통점은 지침만 믿지 않는다는 것입니다. 모두 린트·테스트·CI 같은 정해진 단계로 에이전트를 감싸고, Lauren Tan이 공개한 pstack도 에이전트가 겪은 실패의 교훈을 린트나 스크립트로 남기라고 권합니다. 그래서 다음 질문은 사람의 검토를 없앨지가 아니라, 검토를 어디까지 검증 게이트로 옮길지입니다.
KT도 이 다음 단계를 검토하고 있습니다. 반복되는 리뷰 지적을 린트와 CI 규칙으로 바꿔 같은 지적을 사람이 되풀이하지 않게 하고, 저위험 변경부터 자동 병합을 허용할 기준을 정하며, 에이전트가 앱을 직접 실행해 결과를 확인하는 검증 스킬을 갖추는 일입니다. 사람의 검토를 한꺼번에 없애는 것이 아니라, 위험이 낮은 변경부터 하나씩 게이트에 맡겨 가는 방식입니다. 자동화가 늘어도 사람의 역할이 사라지지는 않습니다. 사람은 변경 하나하나를 읽는 자리에서, 게이트의 기준을 정하고 그 결과에 책임지는 자리로 옮겨 갑니다.
맺으며
코딩 에이전트를 허용하는 조건은 잘 쓴 규칙 파일이 아니라, 에이전트가 쓴 코드도 사람의 코드와 같은 게이트를 통과하게 하는 파이프라인입니다. 허용 범위는 어느 위험 단계까지 어떤 통제 아래 맡길지로 정하고, 허용하기 전에는 세 가지를 확인합니다. 위험 명령과 민감 파일 접근이 도구 단에서 차단되는지, 테스트 통과 기록 없이는 PR을 만들 수도 병합할 수도 없는지, 에이전트가 만든 변경이 표시되고 운영 변경은 사람이 승인하는지입니다. 그 게이트가 갖춰진 다음에는, 사람의 검토를 위험이 낮은 변경부터 게이트로 옮기는 일이 남습니다.
출처
-
JetBrains Research, “AI Coding Agents: Adoption Trends”, 2026년 8월 (2026년 5~7월 전문 개발자 조사), https://blog.jetbrains.com/research/2026/08/ai-coding-agent-adoption-2026/
-
Stack Overflow, 「2026 Developer Survey — AI」, 2026년 10월, https://survey.stackoverflow.co/2026/ai
-
Sonar, 「State of Code Developer Survey report 2026」 (2025년 10월 조사, 전문 개발자 1,149명), https://www.sonarsource.com/state-of-code-developer-survey-report.pdf
-
The Register, “Vibe coding service Replit deleted user’s production database, faked data, told fibs galore”, 2025년 7월 21일, https://www.theregister.com/2025/07/21/replit_saastr_vibe_coding_incident/
-
AI Incident Database, Incident 1152 (사건일 2025년 7월 18일), https://incidentdatabase.ai/cite/1152/
-
OWASP GenAI Security Project, “LLM06:2025 Excessive Agency”, https://genai.owasp.org/llmrisk/llm062025-excessive-agency/
-
금융위원회, 보도자료 「정부와 금융권이 함께 금융권 AX를 가속화해 나가겠습니다」, 2026년 6월 18일, https://www.fsc.go.kr/no010101/87142
-
OpenAI, “Harness engineering: leveraging Codex in an agent-first world”, 2026년 2월 11일, https://openai.com/index/harness-engineering/ (InfoQ 보도로 내용 확인, 2026년 2월 21일, https://www.infoq.com/news/2026/02/openai-harness-engineering-codex)
-
Stripe, “Minions: Stripe’s one-shot, end-to-end coding agents”, 2026년 2월 9일, https://stripe.dev/blog/minions-stripes-one-shot-end-to-end-coding-agents
-
Lauren Tan, “How Cursor Turned AI Agents Into Better Engineers”(Maven 공개 강의), 2026년 8월 12일, https://maven.com/p/e23d9c/how-cursor-turned-ai-agents-into-better-engineers
-
Cursor, pstack (cursor/plugins 저장소), https://github.com/cursor/plugins/tree/main/pstack