
전산업
“텍스트·이미지·음성을 통합 이해해 자연스러운 상호작용이 가능한 AI 서비스를 구현해요.”
언어·시각·음성을 이해하고 텍스트와 음성을 함께 생성하며,
한국의 지식과 문화를 고려해 자연스러운 상호작용을 지원하는 KT의 첫 Omni 모델입니다.
안전성과 강건성을 고려한
상담·민원 대응 AI가 필요한 공공기관
음성 인식·합성을 활용해
AICC 서비스를 고도화하려는 조직
음성과 언어를 함께 분석하는 AI가
필요한 금융·보안 기업
자연스러운 음성 품질과 다양한 표현이
중요한 미디어·콘텐츠 사업자
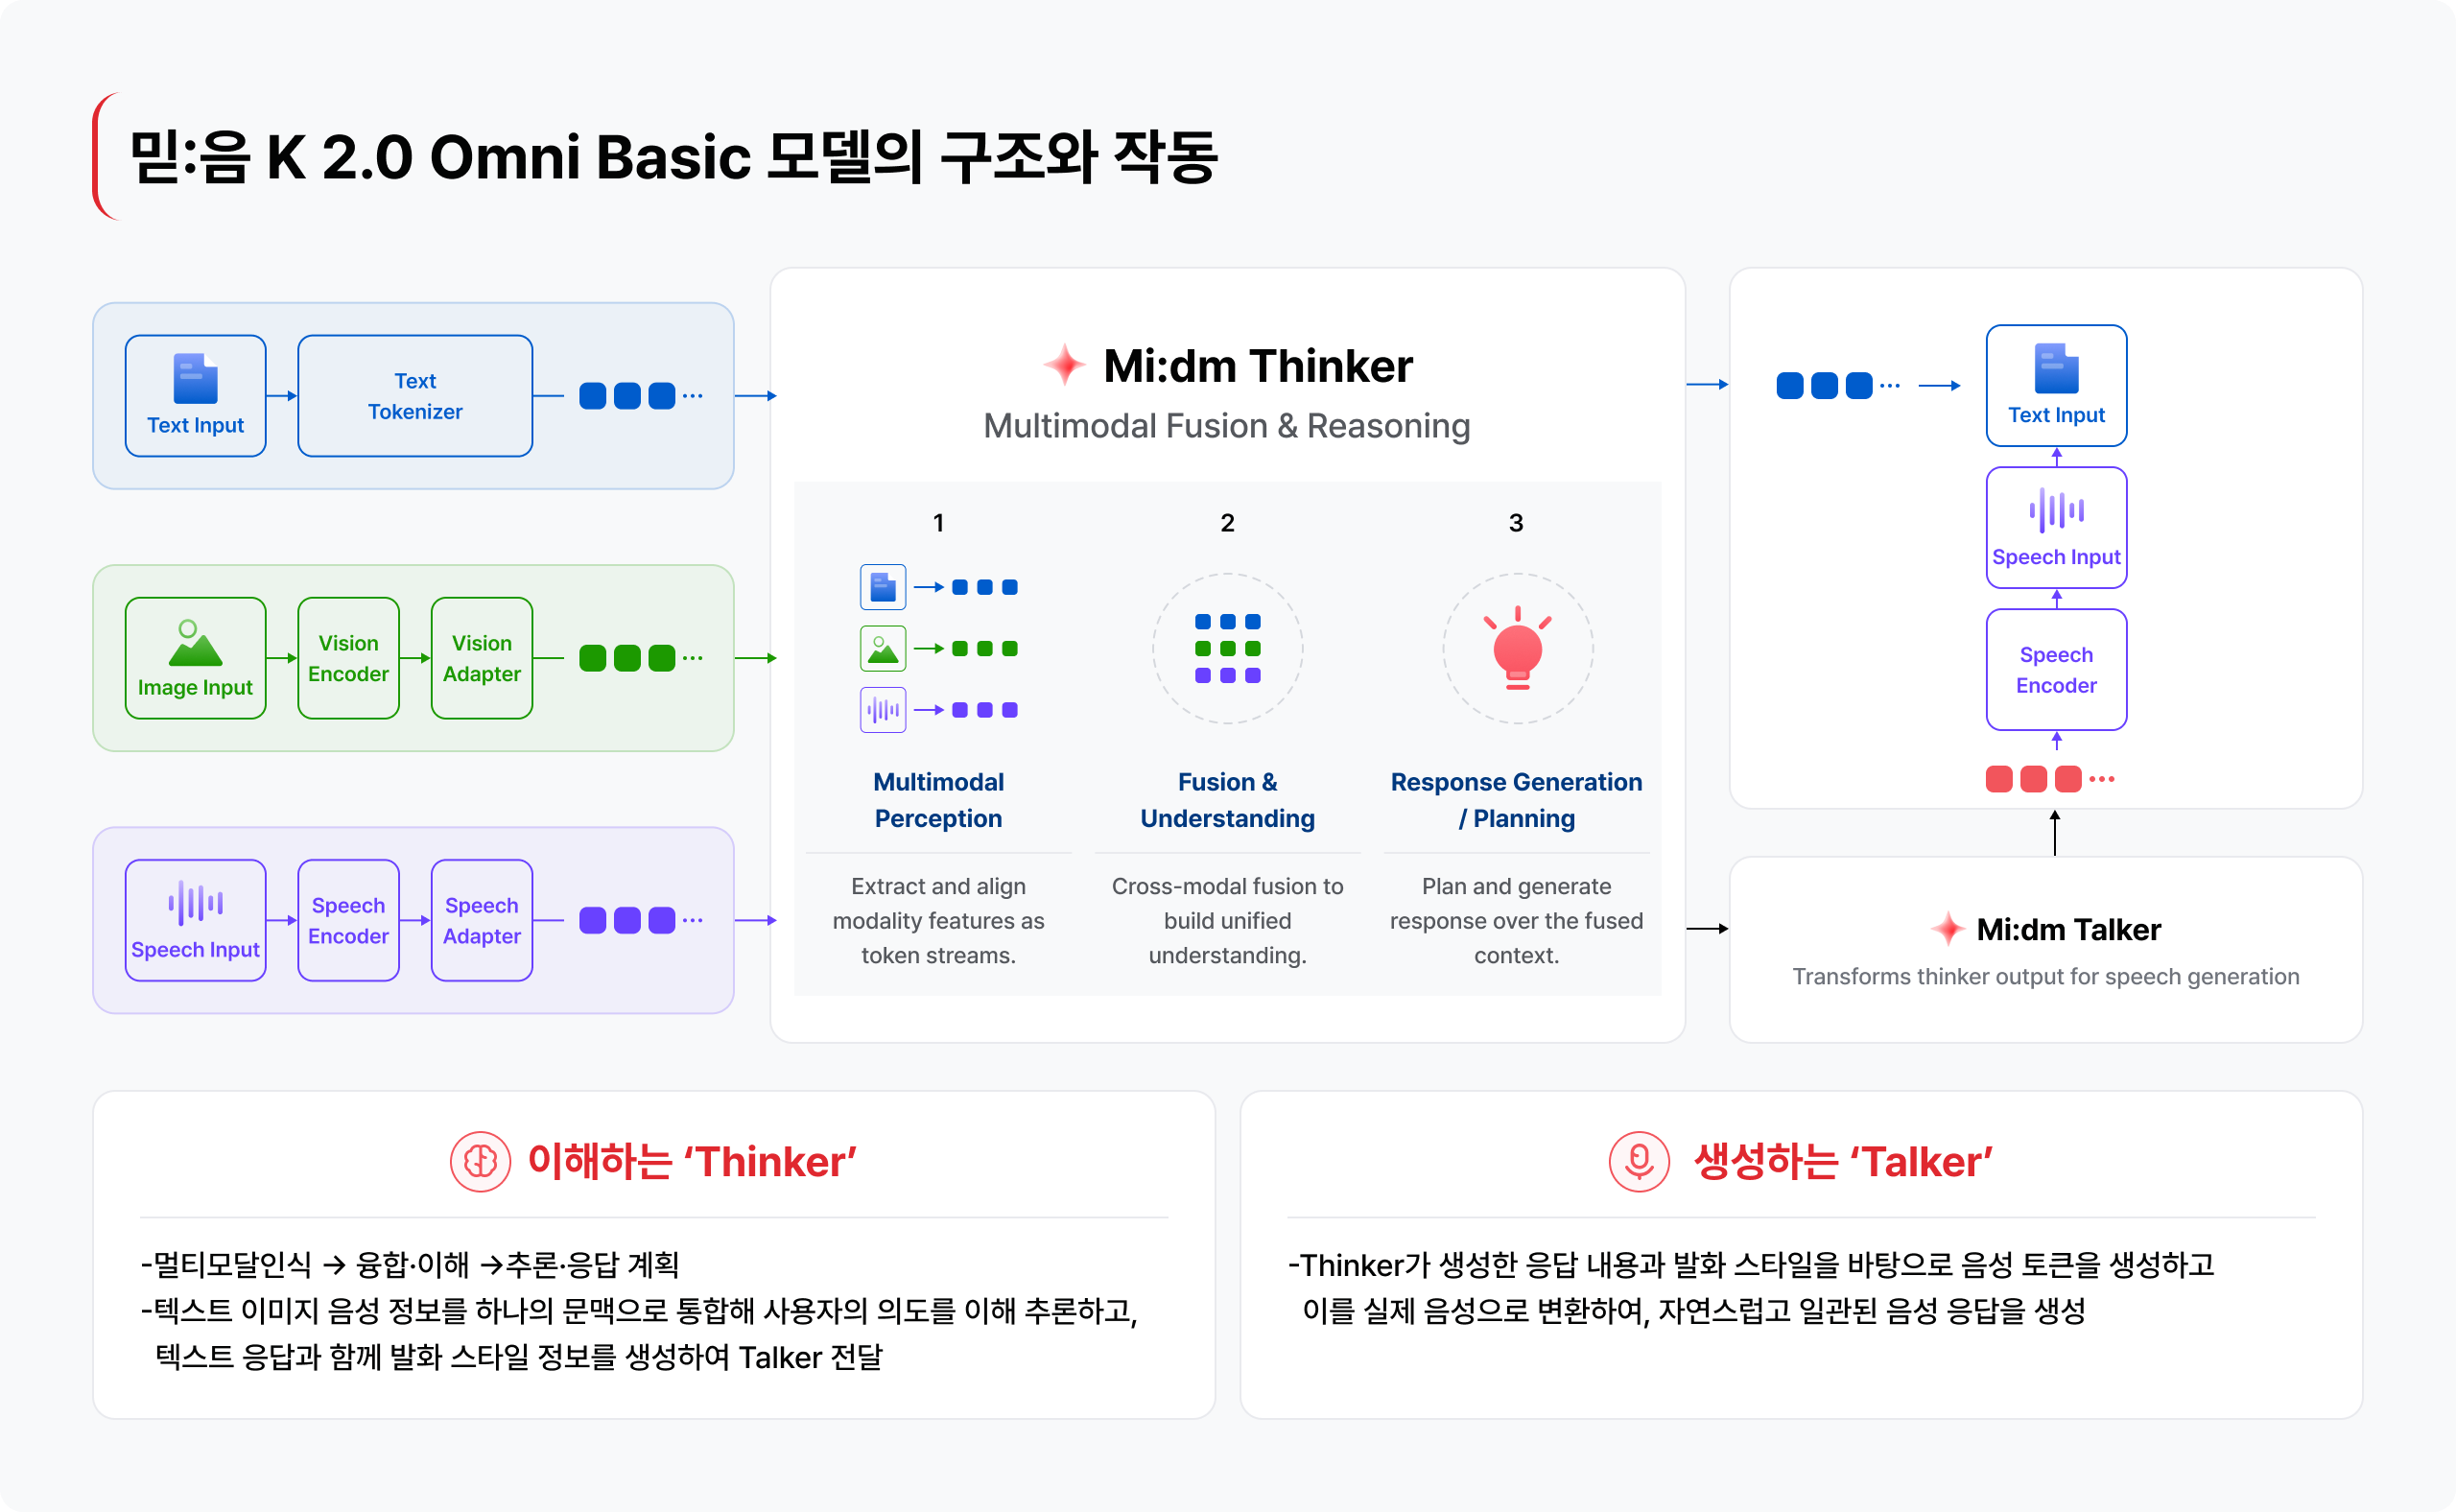
▲ 믿:음 K 2.0 Omni Basic 모델의 구조와 작동 원리
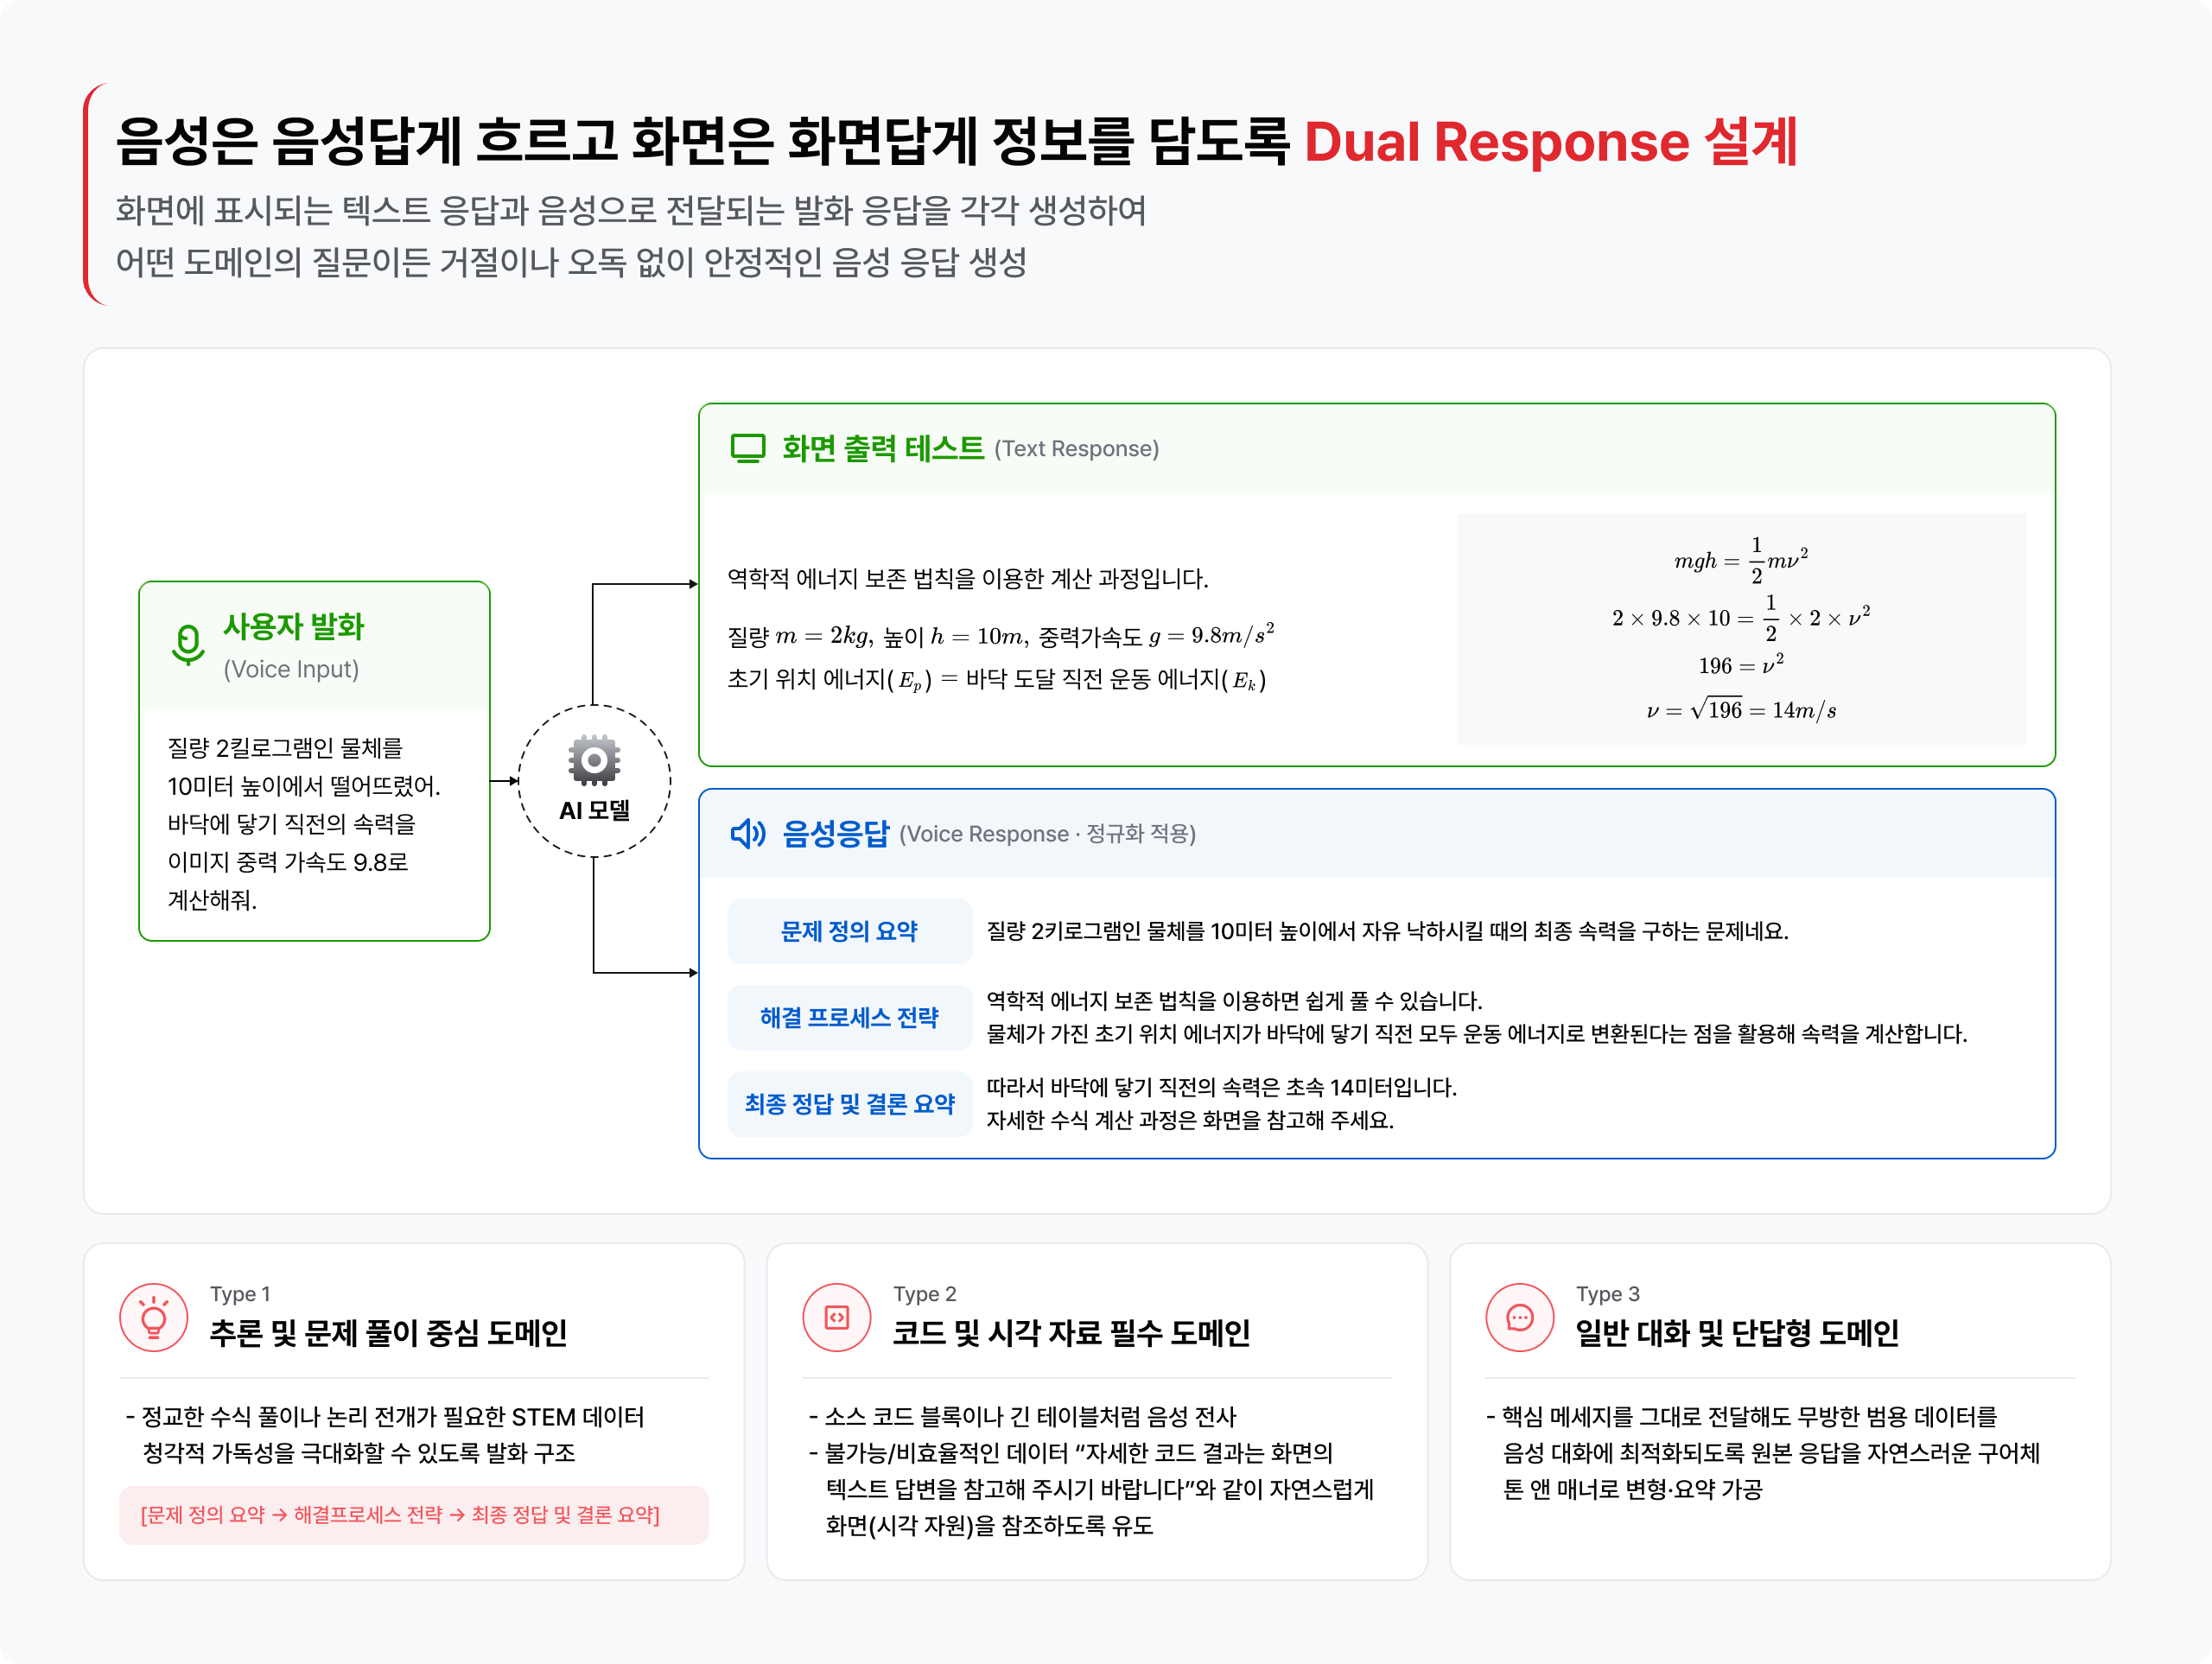
▲ 믿:음 K 2.0 Omni Basic의 Dual Response 구조
“텍스트·이미지·음성을 통합 이해해 자연스러운 상호작용이 가능한 AI 서비스를 구현해요.”
A.텍스트 기반 언어모델과 달리, 언어·시각·음성 세 가지 모달리티를 하나의 모델로 통합한 KT 최초의 Omni 모델입니다.
이미지와 음성이 함께 담긴 요청도 하나의 맥락으로 이해하고 텍스트와 음성으로 응답합니다.
A.화면에 표시되는 텍스트와 음성으로 전달되는 발화 응답을 함께 생성하는 Dual Response 방식을 지원합니다.
수식이나 코드처럼 음성으로 전달하기 어려운 내용은 듣기 자연스러운 형태로 재구성해 전달합니다.
A.한국어를 고려해 개발된 믿:음 언어모델을 기반으로, OCR·표·차트·인포그래픽 등 한국어 문서와 국내 문화·역사·사회 지식을 이해할 수 있도록 개발했습니다.
A.음성 인식(KsponSpeech, LibriSpeech 등)·번역(Fleurs) 평가에서 비교 모델대비 높은 성능을 보이며, 다화자·소음 환경을 고려한 음성 인식을 지원합니다.
음성 합성(TTS)은 AICC·AI 스피커·미디어 등 다양한 분야에 활용할 수 있으며 감정 표현과 긴 발화 처리를 지원합니다.
A.텍스트·이미지·음성의 단독·복합 입력 6개 조합을 대상으로 멀티모달 안전성을 평가했습니다.
교차 모달리티 우회 공격에 대한 강건성도 함께 평가했으며, RAI 평가를 통해 안전성을 확인했습니다.
A.가중치-활성화 양자화, Token2wav의 TensorRT 적용, NVIDIA MPS 도입 등 서빙·추론 최적화를 통해 처리 효율을 개선했습니다.
AICC, 보이스피싱 탐지, 미디어 등 서비스 적용을 고려해 개발했습니다.