
서비스/기타
“AI 학습 인프라의 장애 자동 복구를 적용해 복구 시간을 3.3시간에서 1.9시간으로 약 42% 줄였어요.”
AI 인프라 통합 운영
GPU·AI 가속기 인프라부터 개발·학습·파인튜닝·추론·서빙까지 하나의 환경에서 연결하고 통합 운영하는 AI 플랫폼입니다.
대규모 AI 가속기 자원을 여러 사용자와 워크로드에
효율적으로 배분해야 하는 조직
AI 개발·학습·파인튜닝·서빙을
하나의 플랫폼에서 통합 운영하려는 기업·기관
금융·공공·연구기관 등 폐쇄망에서 보안 요건을 고려한
AI 개발·운영 및 서비스 환경이 필요한 조직
X86-64와 Arm 기반 아키텍처, NVIDIA GPU 및 NPU 등 다양한 AI 가속기의 통합 운영을 지원해요. 지원 범위는 구축 환경에 따라 달라질 수 있어요.
GPU를 워크로드별로 분할·공유해 유휴 자원 감소와 활용률 향상을 지원해요.
개발 코드와 체크포인트를 학습에 연결하고 같은 환경에서 모델 배포를 지원해요.
자원·사용량·정책을 통합 관리하며 폐쇄망, 온프레미스, 클라우드, 하이브리드 환경의 AI 개발·운영을 지원해요. 지원 범위는 환경별 구성에 따라 달라질 수 있어요.
자체 개발한 Sokovan 오케스트레이터를 기반으로 멀티테넌트·멀티노드 워크로드 관리를 지원해요.
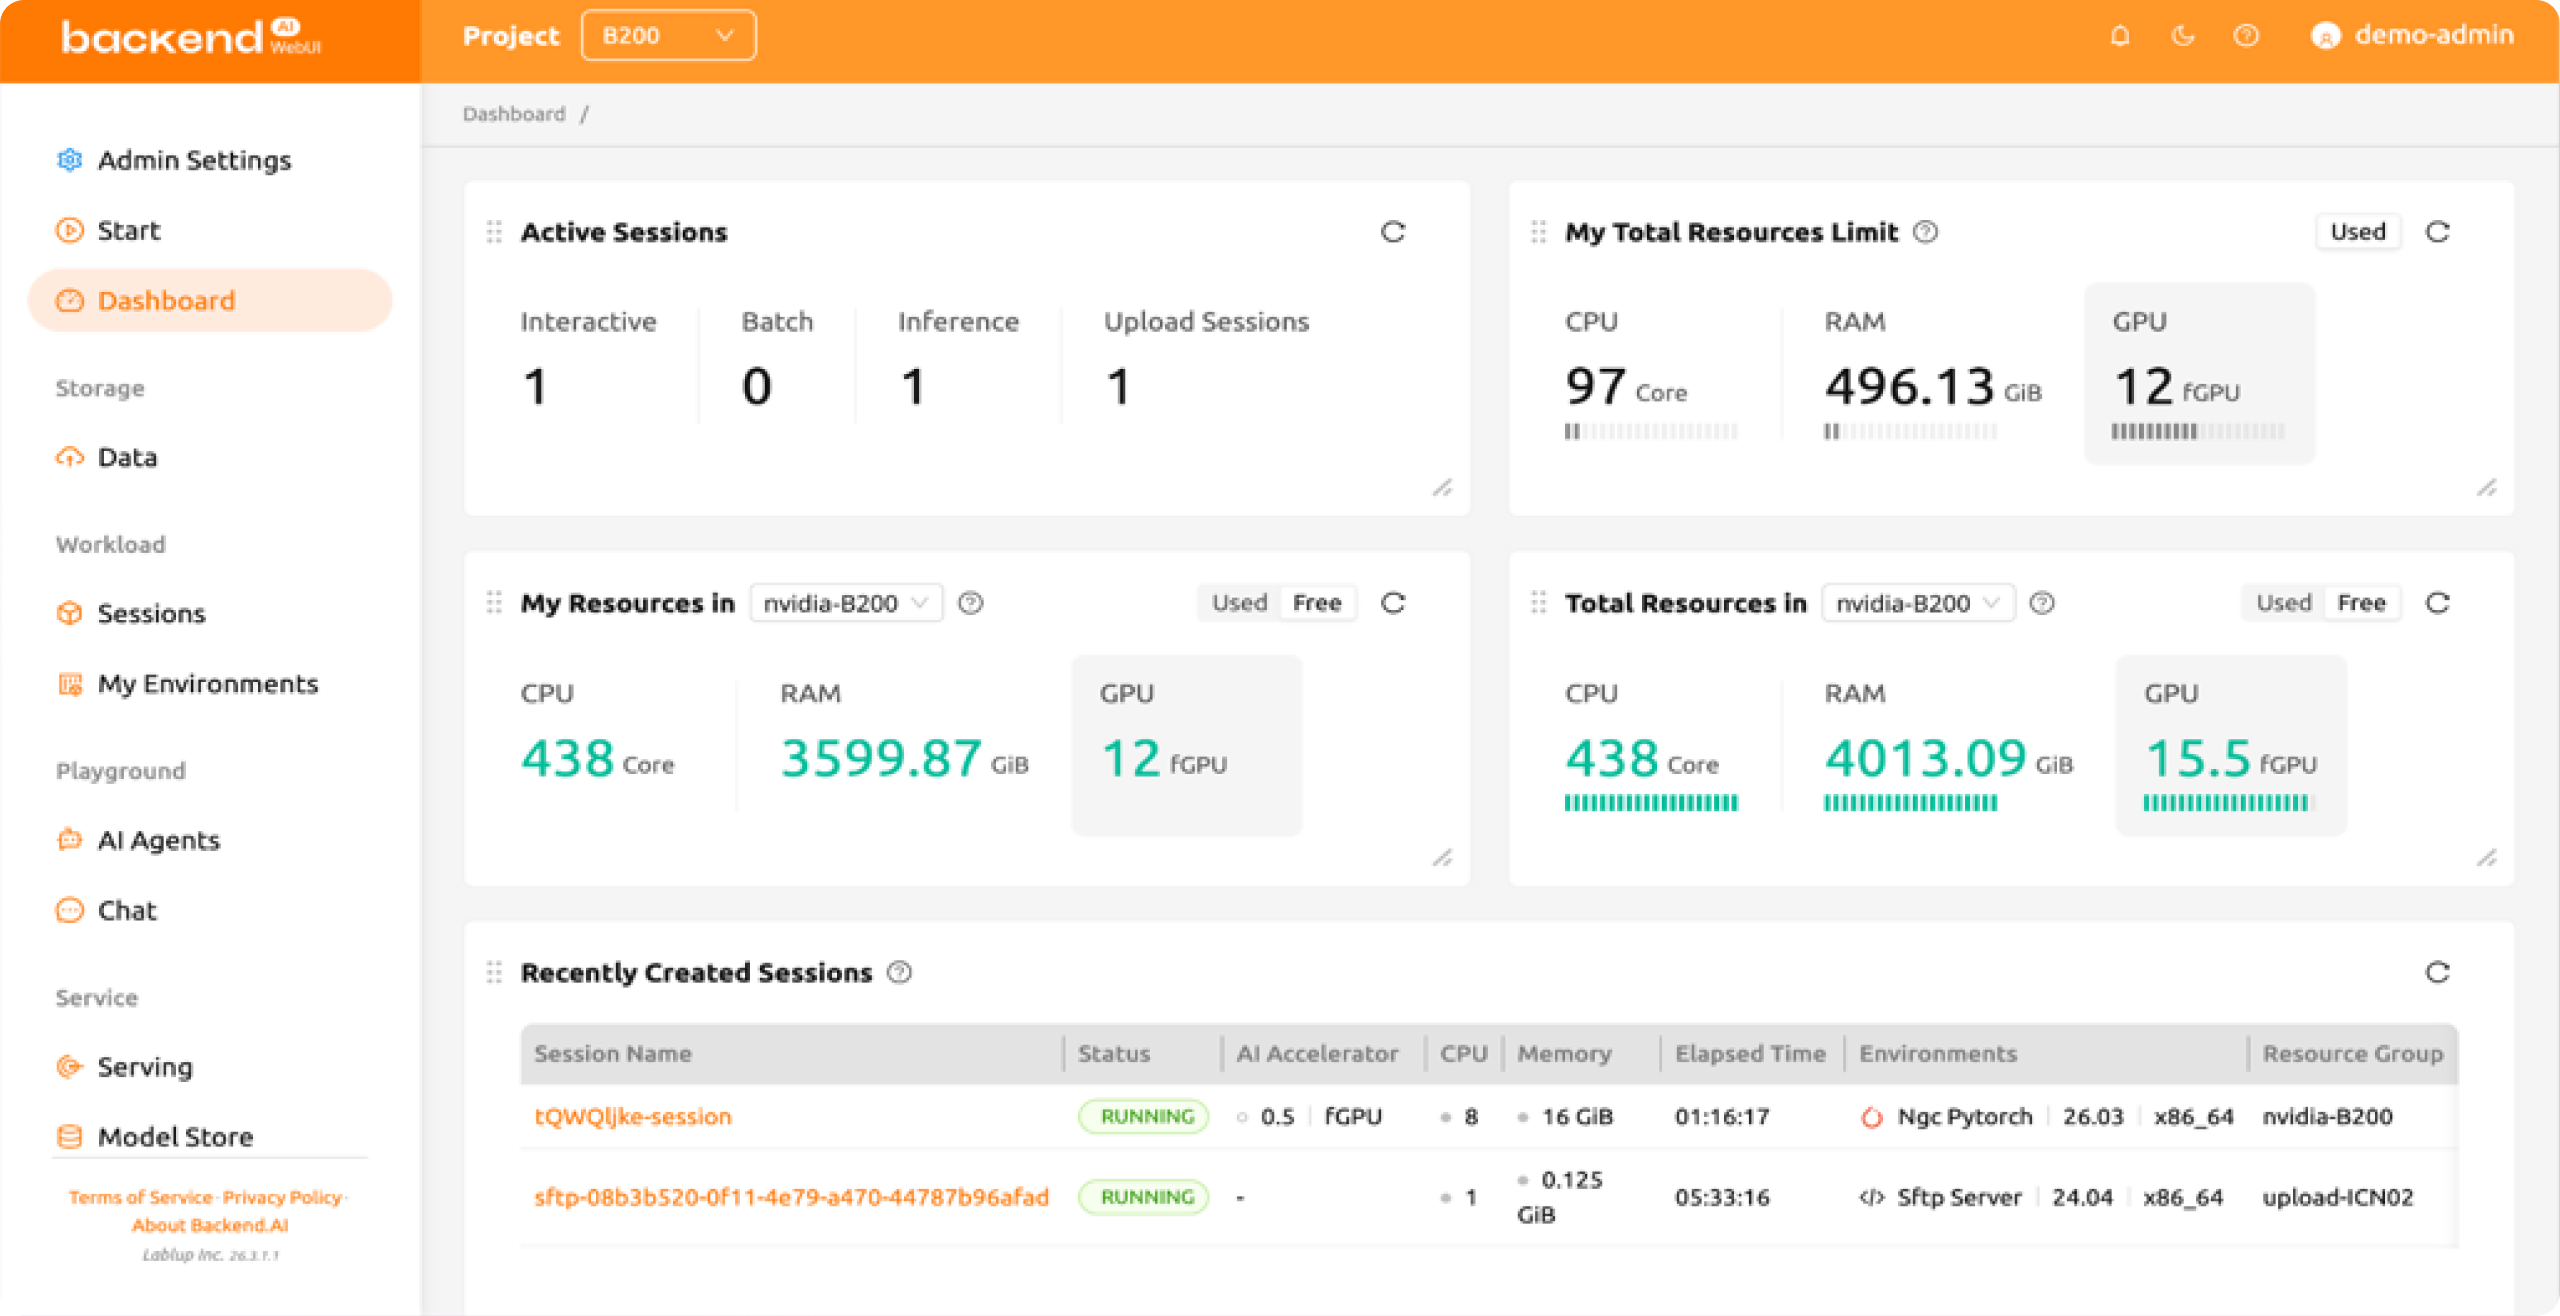
▲ GPU 자원 현황과 실행 중인 AI 세션을 한 화면에서 보는 Backend.AI 대시보드
“AI 학습 인프라의 장애 자동 복구를 적용해 복구 시간을 3.3시간에서 1.9시간으로 약 42% 줄였어요.”
“NVIDIA B200 504장 규모의 GPU 클러스터에서 102B 파라미터 AI 모델의 대규모 사전학습 환경을 운영했어요.”
“120곳 이상의 CSP, 이동통신 사업자, 금융, IT/제조, 방산, 공공, 리서치 기관 등에 적용된 플랫폼이에요.”
“GPU·AI 가속기와 개발·운영 환경을 통합해 AI 인프라 운영 효율 향상을 지원해요.”
A.인프라 관리, 개발 환경, 학습·파인튜닝, 추론·서빙의 통합 운영을 지원합니다.
실험 코드와 체크포인트를 학습에 연결하고, 학습 결과를 같은 플랫폼의 서빙 엔드포인트로 배포할 수 있습니다.
A.vLLM, NVIDIA NIM, SGLang, Hugging Face TGI 등의 추론 엔진 구동을 지원합니다.
밖의 엔진은 Custom/CMD 구성을 통해 지원할 수 있으며, 실제 지원 범위는 버전과 구축 환경에 따라 달라질 수 있습니다.
A.온프레미스·프라이빗 클라우드·퍼블릭 클라우드 구축을 지원하며, 배포·운영 방식과 지원 범위는 고객 환경과 구성에 따라 달라질 수 있습니다.